
Intelligence artificielle
IA privée sur site : quand faut-il héberger ses propres modèles ?
Confidentialité, maîtrise des coûts, souveraineté : dans quels cas une IA installée dans vos locaux devient le bon choix, et ce qu'elle implique côté infrastructure.
BigMind ·
Les services d'IA dans le cloud sont simples à démarrer. Pourtant, de plus en plus d'organisations envisagent d'héberger leurs propres modèles, dans leurs locaux ou leur datacenter. Ce choix a du sens dans certains contextes, moins dans d'autres.
Les bonnes raisons de choisir une IA privée
- Des données sensibles : dossiers médicaux, données juridiques, secrets industriels, informations classifiées. Les garder dans votre périmètre simplifie la conformité.
- Des exigences de souveraineté : certains secteurs publics ou réglementés doivent maîtriser la localisation et l'accès aux traitements.
- Un usage intensif et prévisible : lorsque le volume de requêtes est élevé et stable, une infrastructure dédiée peut devenir plus économique que la facturation à l'usage.
- Des environnements isolés : sites industriels ou réseaux sans accès Internet.
Ce que cela implique
Une IA privée n'est pas qu'un serveur avec une carte graphique. Il faut penser l'ensemble :
- Le calcul : un ou plusieurs serveurs GPU dimensionnés selon la taille du modèle et le nombre d'utilisateurs.
- Le réseau : des liens rapides et sans perte entre serveurs GPU et stockage, surtout lorsque plusieurs serveurs travaillent ensemble.
- Le stockage : un accès rapide aux modèles et aux documents indexés.
- L'énergie et le refroidissement : les serveurs GPU consomment et chauffent beaucoup plus que des serveurs classiques. Votre salle doit pouvoir suivre.
- Le logiciel : le modèle, le moteur d'inférence, l'assistant et sa connexion à vos sources, avec gestion des droits.
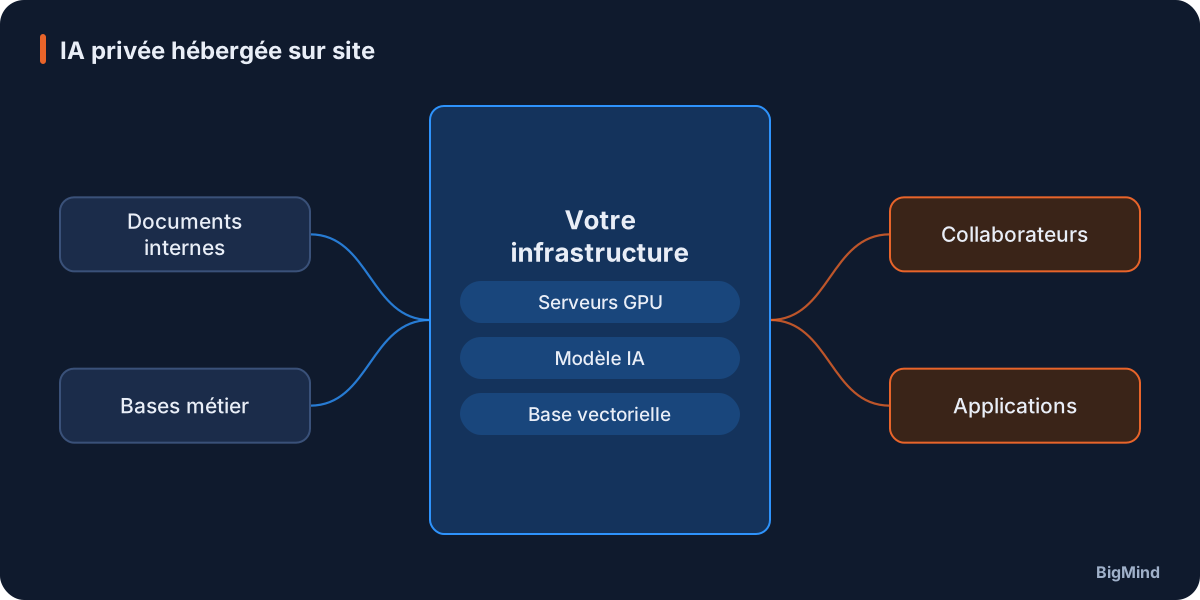
IA privée hébergée sur site
Les points techniques souvent sous-estimés
- Le réseau entre GPU : dès que plusieurs serveurs collaborent, il faut un réseau sans perte, en RoCEv2 (avec PFC et ECN correctement réglés) ou en InfiniBand. Un réseau Ethernet classique dégrade fortement les performances.
- Le moteur d'inférence : des moteurs comme vLLM ou TensorRT-LLM, et la quantification des modèles, permettent de servir plus d'utilisateurs avec le même matériel.
- La recherche documentaire (RAG) : la qualité des réponses dépend autant de l'indexation (découpage des documents, base vectorielle, respect des droits d'accès) que du modèle lui-même.
- L'exploitation : supervision des GPU, gestion des versions de modèles et tests de non-régression avant chaque mise à jour.
Modèles ouverts : un vrai choix
Les modèles ouverts ont beaucoup progressé et couvrent aujourd'hui une large part des usages d'entreprise : questions-réponses sur des documents, résumé, rédaction, classification. Le choix du modèle dépend du besoin, de la langue et des ressources disponibles.
Hybride : souvent le meilleur compromis
Beaucoup d'organisations combinent les deux approches : les données sensibles restent traitées sur site, les usages moins critiques passent par le cloud. L'important est de décider consciemment, cas par cas.
BigMind conçoit et installe des plateformes d'IA privée clé en main : serveurs, réseau, stockage, modèle et assistant, intégrés à votre environnement. Parlons de votre contexte pour savoir si cette approche vous convient.
