
Observabilité
Supervision ou observabilité : quelle différence pour votre SI ?
La supervision vous dit que quelque chose ne va pas. L'observabilité vous aide à comprendre pourquoi. Explications et exemples d'outils, dont Splunk.
BigMind ·
« Le site est lent » : c'est souvent ainsi qu'un incident commence. La supervision classique confirme que les serveurs répondent et que les liens sont actifs. Pourtant, les utilisateurs se plaignent toujours. C'est là que l'observabilité prend le relais.
La supervision : surveiller ce que l'on connaît
La supervision vérifie des indicateurs définis à l'avance : disponibilité d'un équipement, charge processeur, espace disque, état d'une interface. Elle répond à la question « est-ce que ça fonctionne ? ». Indispensable, elle atteint ses limites quand la panne ne correspond à aucun seuil prévu.
L'observabilité : comprendre ce que l'on n'avait pas prévu
L'observabilité croise trois types de données :
- les métriques, pour suivre les tendances ;
- les journaux, pour savoir ce qui s'est passé et quand ;
- les traces, pour suivre une requête d'un bout à l'autre de l'application.
En corrélant ces sources, on remonte plus vite à la cause racine : une base de données saturée, un appel externe trop lent, une modification de configuration réseau.
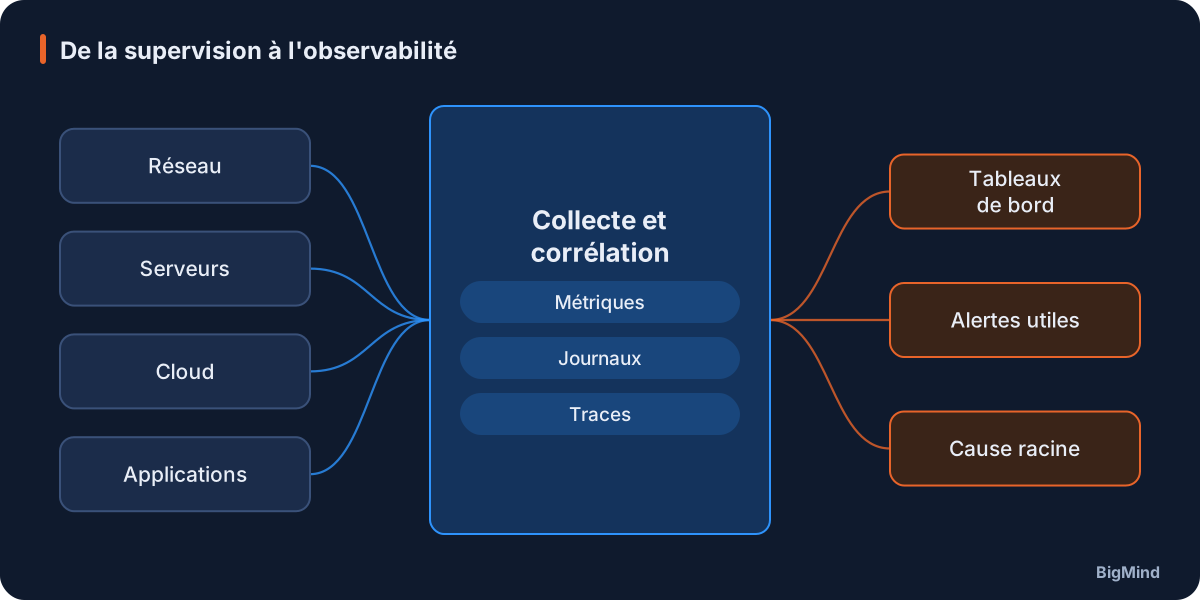
De la supervision à l'observabilité
Quels outils ?
Le marché est large. Des plateformes comme Splunk (Splunk Enterprise, Splunk Cloud Platform, Splunk Observability Cloud) centralisent journaux, métriques et traces et permettent de construire tableaux de bord et alertes. D'autres solutions, commerciales ou open source, conviennent selon la taille et les compétences de l'équipe. Le choix dépend des volumes de données, du budget de licences et des usages visés.
Les standards et pratiques à connaître
- OpenTelemetry est devenu le standard ouvert pour instrumenter les applications et collecter métriques, journaux et traces, sans dépendre d'un seul éditeur.
- La télémétrie réseau moderne s'appuie sur le streaming (gNMI) et les flux (NetFlow, IPFIX) plutôt que sur le seul SNMP.
- Les objectifs de niveau de service (SLO) traduisent l'expérience utilisateur en indicateurs mesurables, par exemple le temps de réponse d'une application, et guident les alertes.
Éviter le piège du « tout collecter »
Collecter toutes les données coûte cher et noie les équipes. Mieux vaut partir des services critiques pour l'entreprise, identifier les sources utiles et définir des alertes qui déclenchent une action. Une alerte sans action associée finit toujours par être ignorée.
Une démarche progressive
- Choisir un service métier prioritaire.
- Raccorder ses sources : réseau, serveurs, cloud, application.
- Construire un tableau de bord orienté utilisateur.
- Définir quelques alertes utiles et les tester.
- Étendre au service suivant.
BigMind met en place la supervision et l'observabilité de votre système d'information, avec Splunk ou d'autres outils selon votre contexte. Échangeons sur vos priorités.
